取得・掲載・発見・認証を分けて設定する
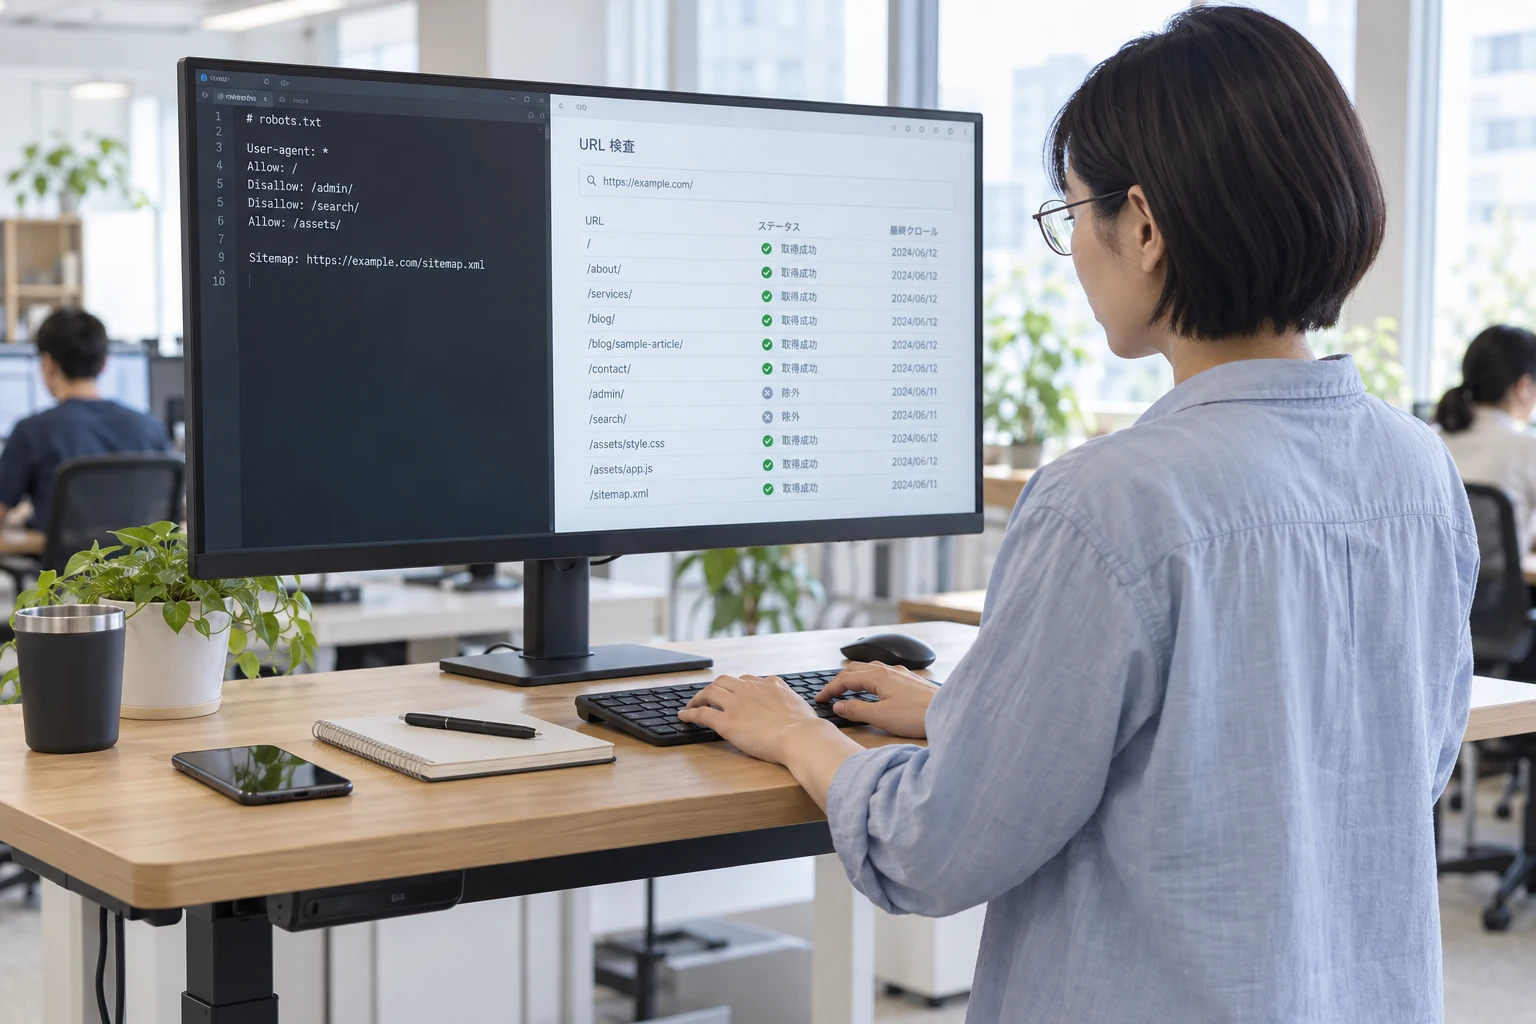
robots.txtはクローラーによる取得の制御、noindexは対応する検索エンジンへの掲載除外、XMLサイトマップは正規URLの発見支援に使います。noindexを読ませるURLは取得を妨げず、機密情報は認証で保護します。公開URL、本文、内部リンク、検索設定の整合も確認します。
4つの手段を目的で使い分ける
最初に区別したいのは、クロール、インデックス、発見支援、アクセス制限です。robots.txtは指定したクローラーへURLの取得可否を伝える仕組みであり、検索結果からの削除や情報保護を保証するものではありません。RFC 9309でも、この規則はアクセス認可ではないと明記されています。URLが他ページから参照されていれば、本文を取得されていなくてもURLだけが認識される可能性があります。
クロール・掲載・発見は別の役割
robots.txtは取得、noindexは検索掲載、サイトマップはURLの発見を補助します。閲覧権限は別途管理します。

検索結果へ表示したくないHTMLにはrobots metaのnoindexを、PDFなどHTML以外のファイルには必要に応じてX-Robots-Tagを使います。ただし、クローラーがnoindexを確認できるよう、そのURLの取得をrobots.txtで同時に止めないことが重要です。
XMLサイトマップは、検索へ届けたい正規URLと更新情報を伝える発見支援です。送信しても取得や掲載が保証されるものではありません。社内資料、確認用URL、個人情報を含む画面など、第三者に見せない情報はログインや適切なアクセス制御で保護します。
- 対象クローラーのURL取得を制御:robots.txt
- 検索への掲載を除外:noindex・X-Robots-Tag
- 正規URLの発見を支援:XMLサイトマップ
- 閲覧自体を制限:認証・権限管理
- 緊急の検索削除:対象サービスの公式手順も確認
- robots.txt
- クローラーの取得
対象のユーザーエージェントとパスを指定。閲覧制限や検索除外の保証には使いません。
- noindex
- 対応する検索への掲載
HTMLのmetaやHTTPヘッダーで指定。規則を読むために取得を妨げないことが必要です。
- サイトマップ
- 正規URLの発見
検索へ届けたいURLを案内。送信しても掲載は保証されません。
- 認証・権限
- 情報へのアクセス
関係者だけが見る資料や管理画面を保護。検索制御とは別に設計します。
実際の応答、robots meta、X-Robots-Tag、canonical、内部リンク、robots.txt、サイトマップを照合します。
URLごとに公開方針を決める
設定ファイルから考え始めると、部署ごとに異なる意図が混ざります。まずURLを「検索・AIから見つけてほしい公開情報」「公開はするが検索結果へ出さない情報」「指定クローラーの取得を抑えたい経路」「関係者だけが閲覧する情報」に分類します。企業サイトならサービス、会社情報、実績、FAQは原則として公開対象です。一方、確認中のプレビュー、管理画面、検索結果ページ、重複する絞り込みURLなどは、目的とシステム構成を確認して個別に扱います。
自治体・団体サイトでは、終了した制度や募集のページを単純に隠すと、過去情報を確認したい利用者の手掛かりも失われます。現行情報への案内、終了日、後継ページの有無、保存方針を決めたうえで、公開継続、終了案内、転送、noindex、削除のいずれが適切かを判断します。設定の担当者だけで決めず、情報所管、広報、システム管理の確認者を台帳に残します。
- URLとページの目的
- 想定する利用者と公開範囲
- 検索・AIから発見される必要性
- canonicalとして扱うURL
- 掲載開始日・終了日・後継情報
- 情報所管・承認者・実装担当
本文・正規URL・検索設定を揃える
検索へ届けたいページは、200の正常な応答、自己参照または適切なcanonical、たどれる内部リンク、XMLサイトマップへの収録を同じ方針に揃えます。サイトマップには、検索結果へ出したい正規URLを選びます。noindexのURL、転送元、エラーページ、重複URLを機械的に含めると、サイト側の意図が矛盾します。更新日は、デザイン部品の再生成ではなく、主要な本文や判断情報が実際に変わった時に更新します。

見せる・検索に出さない・アクセスさせないを分け、目的に合う制御方法を選びます。
図解を別タブで開く検索から外すページはnoindexを返し、サイトマップと主要な案内リンクから外すか、利用者に必要な導線だけを残します。既に認識されているURLへnoindexを追加する場合は、クローラーが変更を確認できる状態を保ちます。
robots.txtで先に遮断するとnoindexを読めないため、意図した除外を確認できません。公開前はHTMLだけでなく、HTTPヘッダー、canonical、レスポンスコード、robots.txt、サイトマップを実URLで確認します。
- 公開対象:200・取得許可・canonical・内部リンク・サイトマップを整合
- 検索除外:noindexを取得可能な状態で返す
- 非公開:認証で保護し公開URLとして扱わない
- 転送:移動先と目的が対応する場合に設定
- サイトマップ:正規URLだけを自動生成
- 公開後:検査画面と実際のレスポンスを照合
AIクローラーの用途と設定を分ける
AI関連の取得方針は、対象サービスとユーザーエージェントごとに決めます。検索への掲載、モデルの学習、利用者の依頼によるアクセスでは目的が異なります。公式資料で用途と制御方法を確認し、方針、承認者、確認日を記録します。
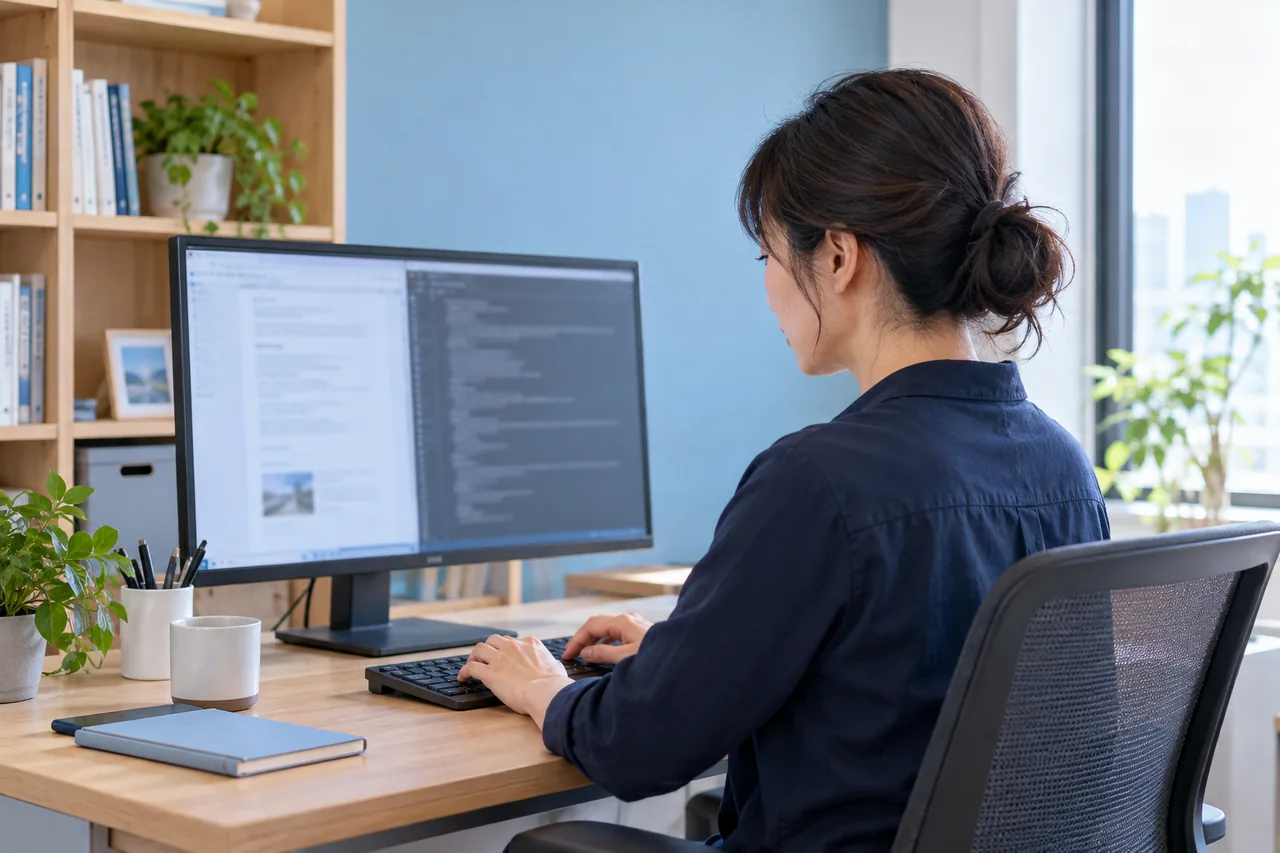
OpenAIの現行資料では、OAI-SearchBotは検索、GPTBotはモデル学習に関するクローラーとして説明され、それぞれのrobots.txt設定は独立しています。検索向けの取得を許可し、学習向けは拒否する指定も可能です。
ChatGPT-Userは利用者の依頼に伴うアクセスで、自動巡回とは異なり、robots.txtが適用されない場合があります。Googleなどでnoindexを使う際に規則の取得が必要なことと、機密情報を認証で守ることも、別の条件として確認します。
- 対象サービスとユーザーエージェントを特定
- 検索・回答参照・学習など用途を区別
- 許可・拒否の理由と承認者を記録
- noindexを読ませる経路を遮断しない
- 機密情報はクローラー設定に依存しない
- 公式仕様の確認日を台帳へ残す
公開前後に7段階で確認する
実装は、①URL台帳を最新化、②各URLを公開・検索除外・クロール制御・認証保護へ分類、③canonicalと内部リンクを確認、④robots metaとHTTPヘッダーを確認、⑤robots.txtとXMLサイトマップを生成、⑥PC・スマートフォンとクローラー向け応答を検査、⑦公開後に検索管理画面とサーバーログを確認、の順で進めます。設定を一つずつ追加するのではなく、同じURLに対する指示を横並びで確認することが重要です。
公開後の点検では、重要ページが誤ってnoindexになっていないか、テスト環境の設定が本番へ残っていないか、サイトマップへ終了URLが混ざっていないかを優先します。CMSやテンプレートの共通設定は多数のページへ影響するため、個別ページだけでなくカテゴリ単位の抽出確認も行います。異常を見つけたら、変更前の設定、影響URL、修正内容、再確認日時を記録し、同じ原因を公開手順へ戻して再発を防ぎます。
- 本番TOP・主要サービス・最新記事を抽出確認
- noindex・canonical・HTTPヘッダーを実URLで確認
- robots.txtの対象クローラーとパスを確認
- サイトマップのURL・最終更新日・応答を確認
- テスト環境と管理画面が認証されているか確認
- 検索管理画面とアクセスログで取得状況を確認
- 変更履歴・影響範囲・再確認結果を保存
FAQ
よくある質問
robots.txtでDisallowにすれば検索結果から消えますか?+
検索結果からの削除手段としては使いません。robots.txtは主にクロール要求を制御する仕組みで、外部リンクなどからURLが認識される可能性があります。検索結果へ表示させない場合は、取得可能な状態でnoindexを返すか、非公開情報なら認証で保護します。
noindexのページをXMLサイトマップに残してもよいですか?+
サイトマップには検索へ届けたい正規URLを載せるため、原則としてnoindexのURLは外します。既に検索側が認識しているページへnoindexを追加した直後は、クローラーが規則を確認できる状態を保ち、反映を確認してから運用を整理します。
テスト環境はrobots.txtだけで隠せますか?+
隠せません。robots.txtはアクセス制御ではなく、URLの存在や内容を第三者から保護する仕組みではありません。テスト環境は認証やネットワーク制限で保護し、本番公開時にnoindexや認証設定が誤って引き継がれていないことも確認します。
参考にした一次情報
本記事の確認に用いた公式資料です。適用条件は、各参照先の説明もご確認ください。